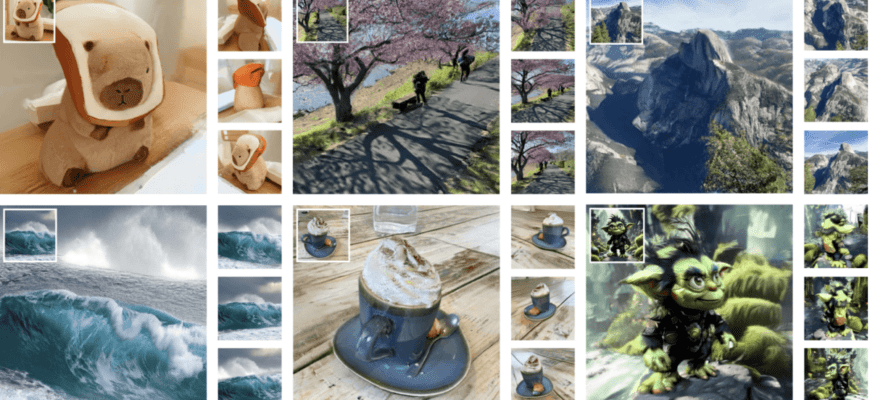
Google Research и Google DeepMind разработали систему Bolt3D, которая превращает фотографии в сложные 3D сцены за 6,25 секунды, если известна позиция камеры. Это достигается с использованием GPU Nvidia H100, тогда как другие системы требуют на это минуты или часы.
Bolt3D назначает каждому пикселю его положение в 3D пространстве и цвет, после чего определяет прозрачность и пространственное расширение. Для хранения данных система применяет метод “Gaussian splatting”, который организует 3D сцену с помощью трехмерных гауссовых функций на 2D сетках. Эти функции отслеживают позиции, цвета, прозрачность и пространственную информацию, что позволяет пользователям просматривать сцену с любого угла в реальном времени. Чтобы держать файлы небольшими, система убирает прозрачные части и эффективно сжимает оставшиеся данные.
Тесты показывают, что Bolt3D значительно превосходит существующие быстрые методы, такие как Flash3D и DepthSplat, генерируя реалистичное содержимое для скрытых частей сцены, чем они не могут похвастаться.
Для этой возможности команда обучила систему на около 300,000 3D сцен с использованием фото-реконструкций и компьютерных моделей. Такой объем данных помогает системе делать обоснованные предположения о частях сцены, которые она полностью не видит.
Однако, Bolt3D имеет ограничения. Он не справляется с очень мелкими деталями, прозрачными материалами и сильно отражающими поверхностями. Качество результата зависит и от качества исходного фото, и от размера конечной сцены.
Несмотря на это, Bolt3D делает шаг вперёд в создании 3D контента. Работа указывает, что его скорость может впервые сделать возможной генерацию масштабных 3D сцен. Интерактивные демонстрации можно найти на сайте проекта. Публичная доступность пока неизвестна.
Параллельно Stability AI выпустили свою систему SPAR3D, которая создает 3D объекты из одной картинки. Главное отличие в том, что SPAR3D работает с отдельными объектами, а Bolt3D – со сценами.