Нейросети пишут статьи, посты, письма и даже дипломные работы. Иногда отличить машинный текст от человеческого почти невозможно. Разберёмся, как найти нейросеть в тексте и какие инструменты помогут определить ИИ в тексте.
Почему вообще это стало проблемой
Года три назад распознать генерёжку было элементарно — тексты выглядели как инструкции к пылесосу, написанные на китайском и переведённые через Google. Сейчас всё иначе.
Генеративные модели научились имитировать человеческий стиль. Они копируют структуру, подбирают нужные слова и даже добавляют эмоции. ChatGPT может написать пост в стиле Довлатова (ну, почти), а Claude — сгенерировать научную статью, которую не отличишь от настоящей.
Поисковики снижают позиции сайтов с машинным контентом. Google и Яндекс умеют находить признаки генерации. Причём Google в этом преуспел больше — он начал активно удалять из выдачи сайты с ИИ-контентом ещё в 2023 году. Исследование Originality вообще показало жёсткую картину: все деиндексированные сайты содержали следы ИИ в тексте. Все, без исключений. Обычно гугл рубит всю генерёжку 2 раза в год, во время спам апдейтов.
Но это ещё полбеды.
Нейросети придумывают факты. Они создают правдоподобные, но ложные данные. Это называется галлюцинациями, и проблема серьёзнее, чем кажется. Модель не проверяет информацию, а генерирует то, что кажется логичным. Ссылки на несуществующие исследования, выдуманная статистика, искажённые цитаты.
Читатели чувствуют фальш. Большинство контента в интернете — вода. Нейросети обучались на этих текстах и воспроизводят тот же стиль. Получается замкнутый круг: машина перерабатывает слабые тексты и создаёт похожие. А потом эти тексты снова попадают в обучающую выборку для следующего поколения моделей.
Проверка на ИИ в тексте особенно важна для преподавателей, редакторов и заказчиков контента.
Отличить ИИ-текст от человеческого — полезный навык. Но ещё полезнее — уметь писать с помощью ИИ так, чтобы результат звучал как человек. Курс от Нетологии научит именно этому.
Сервисы для поиска ИИ в тексте — что работает, а что нет
Детекторов сейчас как грибов после дождя. Каждую неделю появляется новый “революционный” инструмент с “точностью 99,9%”. Спойлер: точности 99,9% не будет ни у кого. Одни анализируют структуру предложений, другие — частоту слов, третьи — предсказуемость текста. Я протестировал штук десять за последние месяцы. Вот что реально работает.
GigaCheck — детектор от Сбера
Ссылка – https://developers.sber.ru/portal/products/gigacheck
Работает только с русским языком, что одновременно плюс и минус. Плюс — потому что специализация. Минус — если нужен английский, придётся искать другой инструмент.
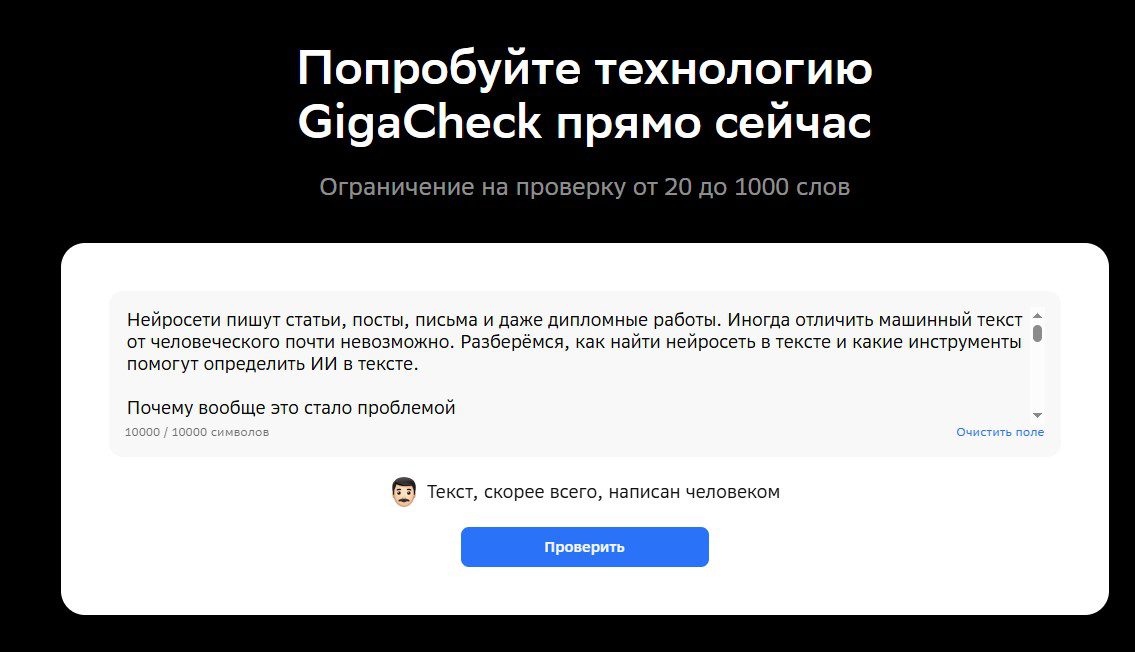
Разработчики обещали точность до 94,7% летом 2024-го. Сейчас, судя по моим тестам, где-то 70-80%. Что, впрочем, неплохо на фоне конкурентов. Доступен бесплатно на сайте и в телеграм-боте. Лимит — 10 000 символов.
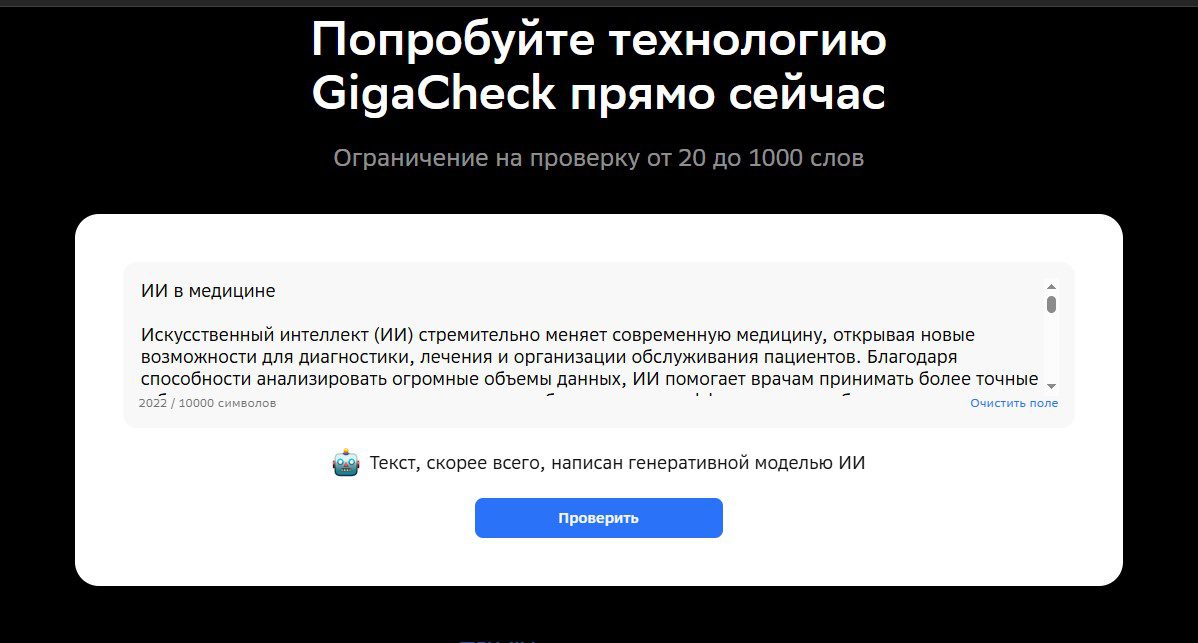
Интерфейс примитивный до безобразия: вставил текст, нажал кнопку, получил процент. Никаких графиков, детализации или выделения подозрительных фрагментов. Зато быстро.

Из проблем — иногда путает хорошо написанные человеческие тексты с машинными. Особенно если автор пишет структурированно и использует списки. GigaCheck видит структуру и сразу: “Это робот!”. Хотя нет.
Два примера (сгенерированная статья про ИИ в медицине от GPT чата и статья, которую вы сейчас читаете).
Content at Scale (теперь они brandwell.ai) — неожиданно годный для русского
Ссылка https://brandwell.ai/ai-content-detector/
Знаете, что меня удивило? Западный сервис, который нормально работает с кириллицей. Обычно всё наоборот — заявляют поддержку 30 языков, а по факту только английский более-менее.
Тестировал на тех же текстах из первого примера. Content at Scale распознал генерёжку также как и GigaCheck.
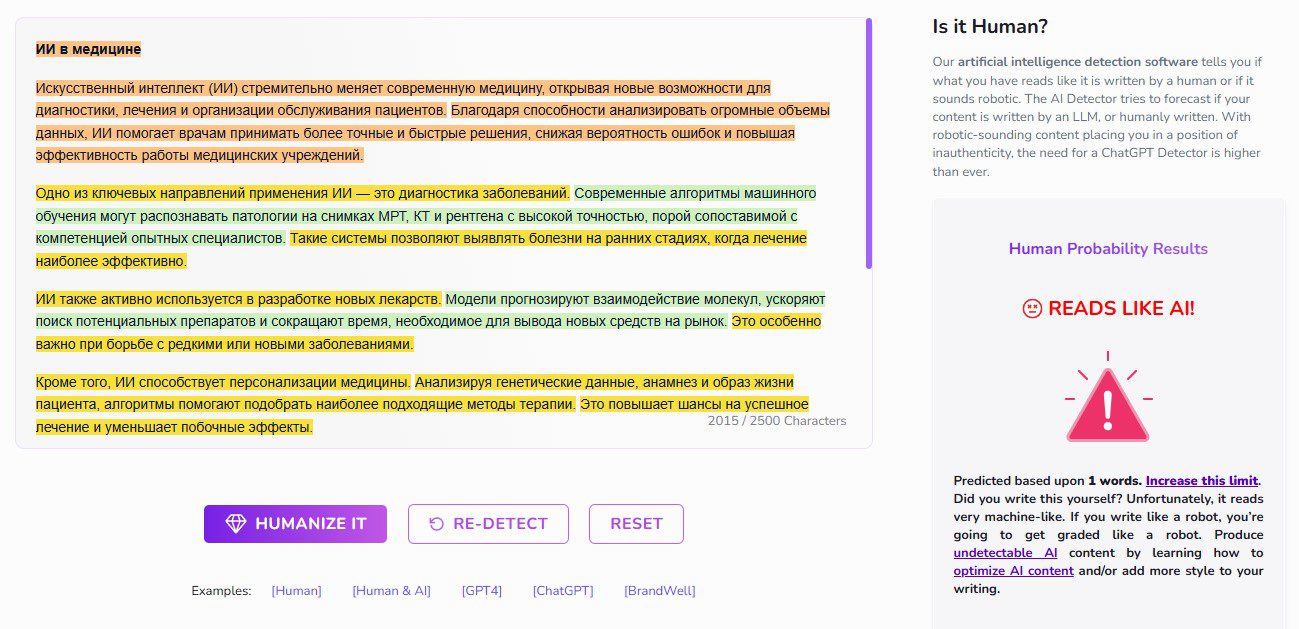
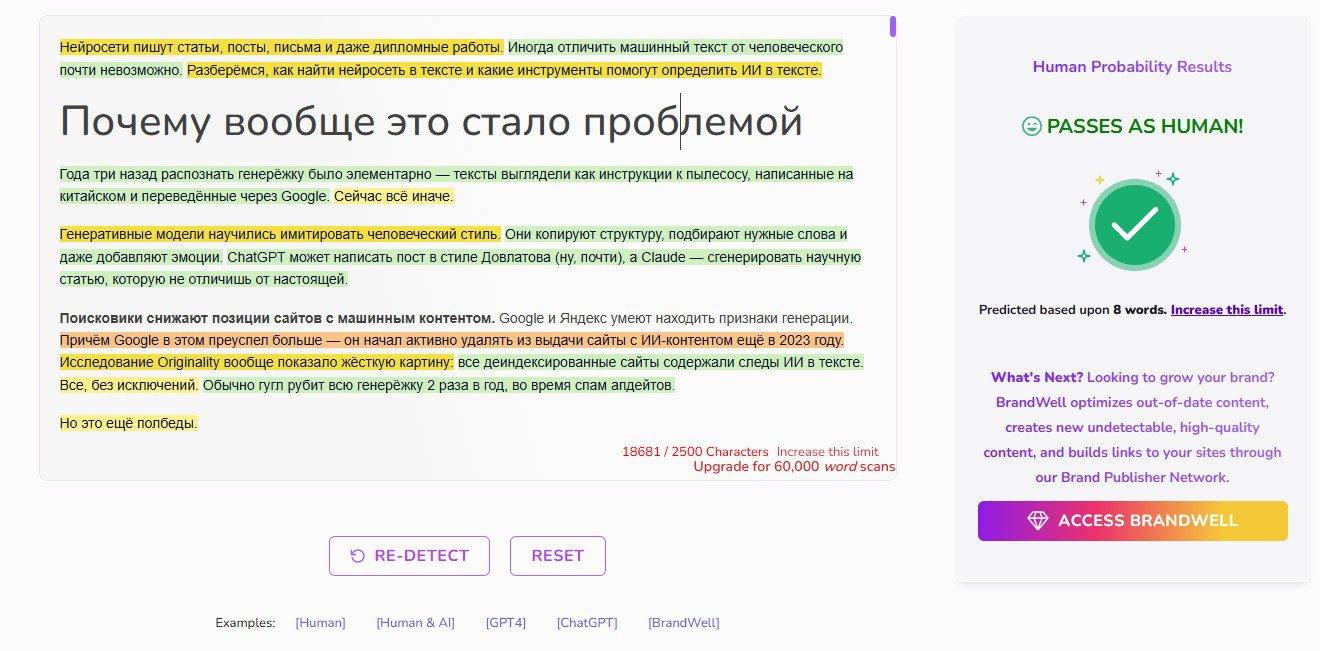
Никаких ограничений для бесплатников. Можно проверять хоть весь день. Работает быстро даже с лонгридами на 20 000 символов.
GPTZero — старичок, который ещё держится
Один из первых детекторов, появился где-то в начале 2023-го. Тогда казался магией. Сейчас — просто нормальный рабочий инструмент.
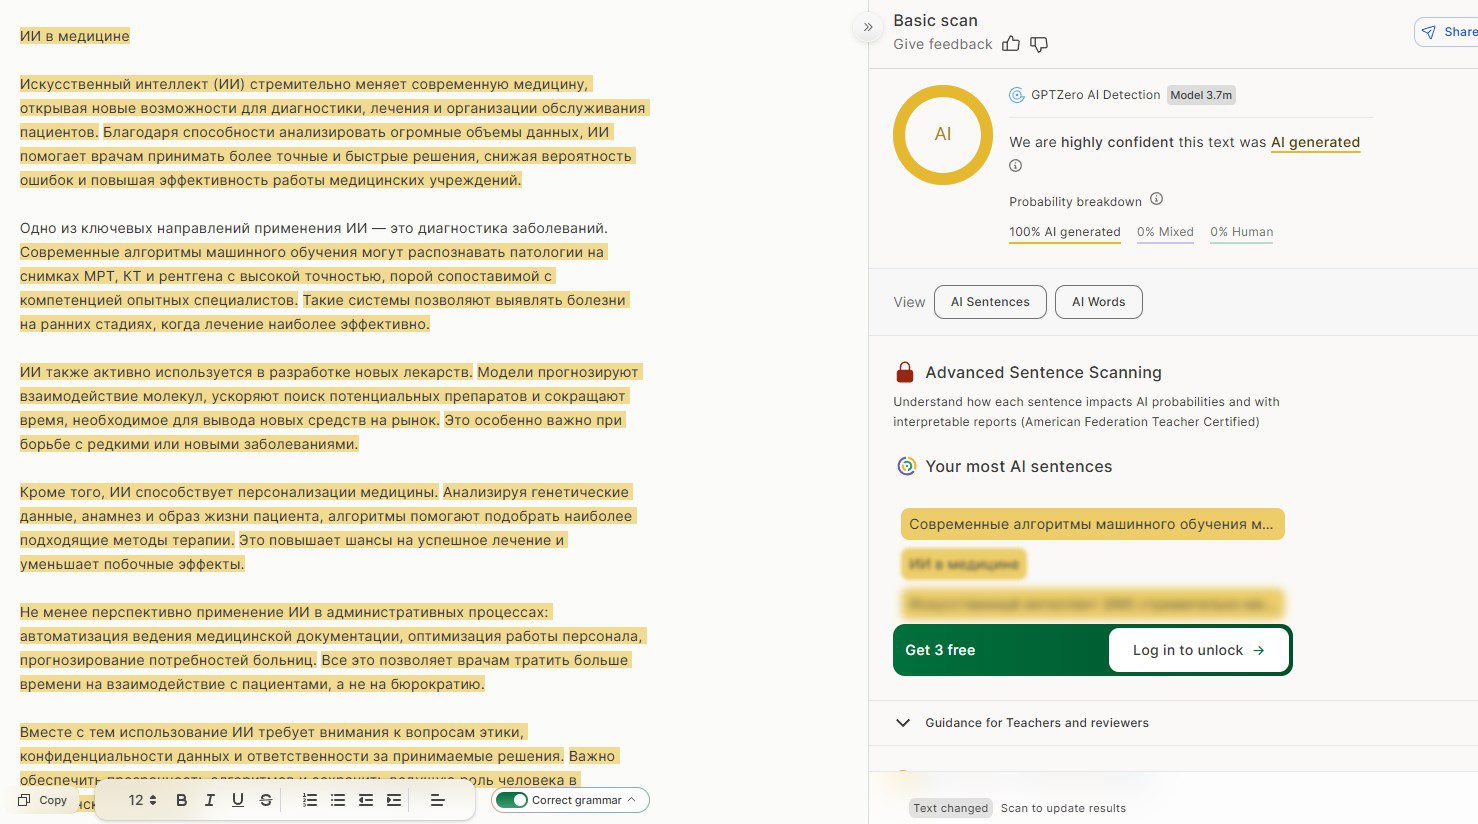
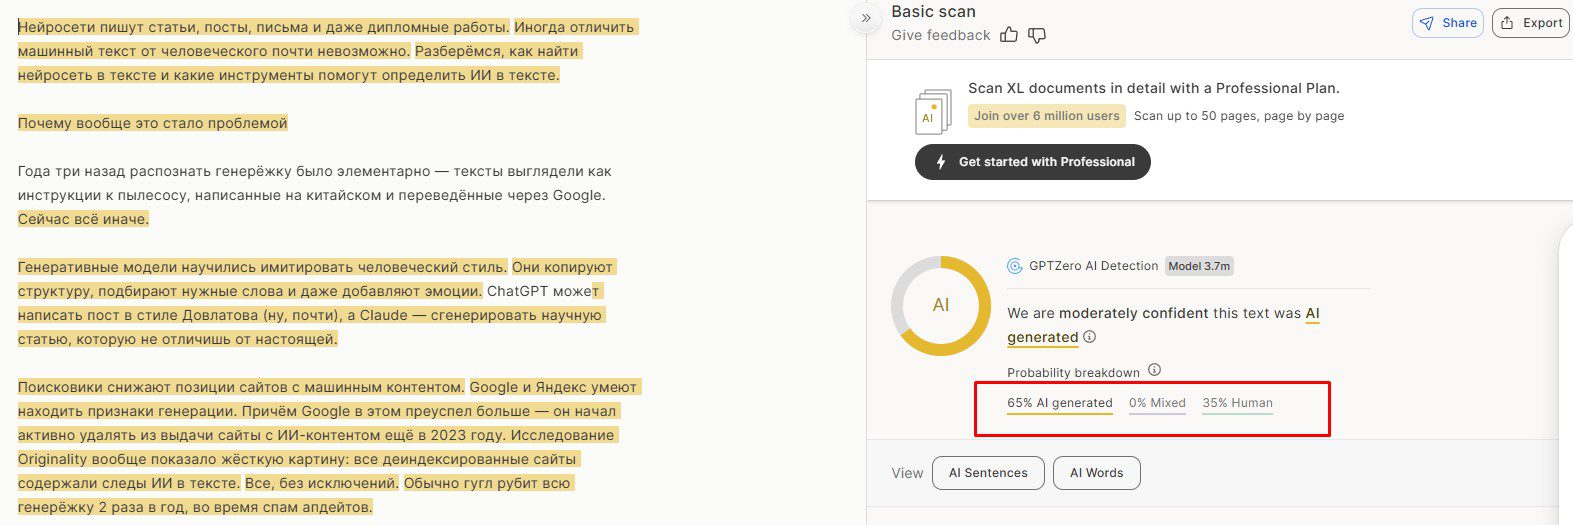
Поддерживает несколько языков, с русским справляется средне. Загрузка текстовых файлов работает, это удобно. Показывает не только общий процент, но и анализирует отдельные предложения.
Бесплатная версия — до 10 000 символов (даже если загрузить ему больше, он проверит только первые 10к знаков). Платная — $15 в месяц. Сервис помечает конкретные абзацы, которые считает генерёжкой. Фича полезная, но часто выдаёт совпадения, которые на самом деле не совпадения. наш текст он только на 35% определил как человеческий, но генерёжку определил со 100% уверенностью.
Copyleaks — для тех, кто работает с английским
Ссылка https://copyleaks.com/ai-content-detector
30 языков, точность “более 99%” (допустим). До 25 000 символов бесплатно, что уже приятно. Есть расширение для Google Docs — можно проверять прямо в документе.
С английским работает отлично. Проверял несколько статей, в том числе статью коллеги, который честно признался, что использовал Claude для чернового варианта. Copyleaks вычислил 78% машинного текста.
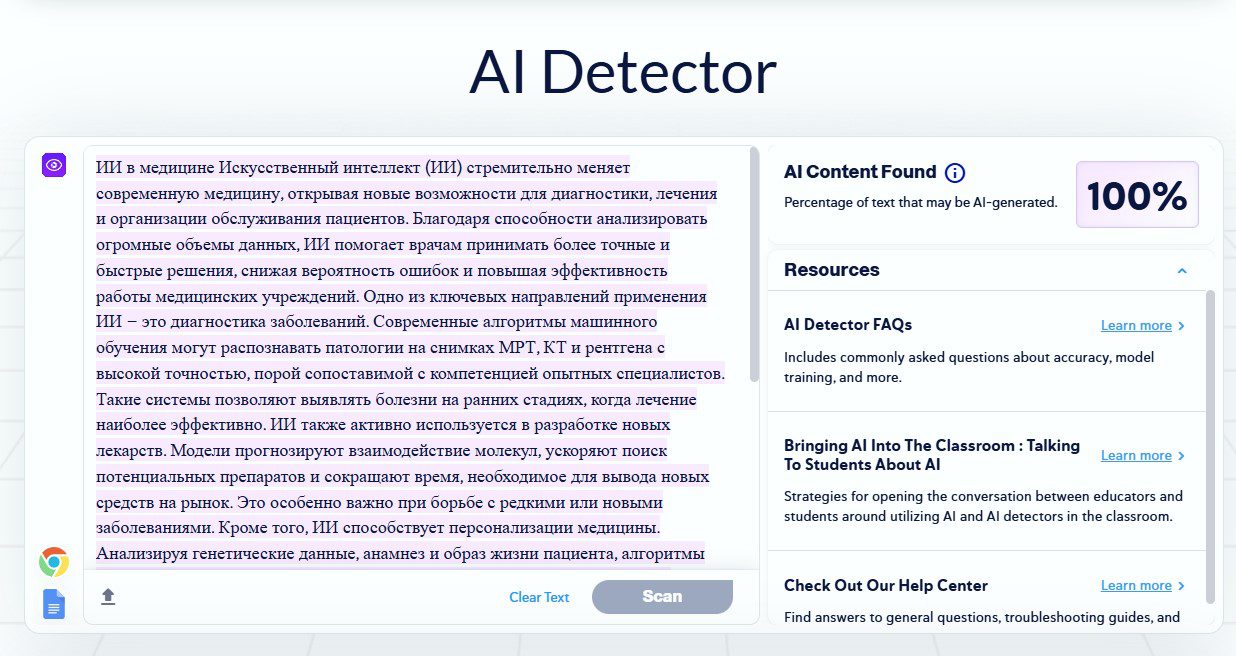
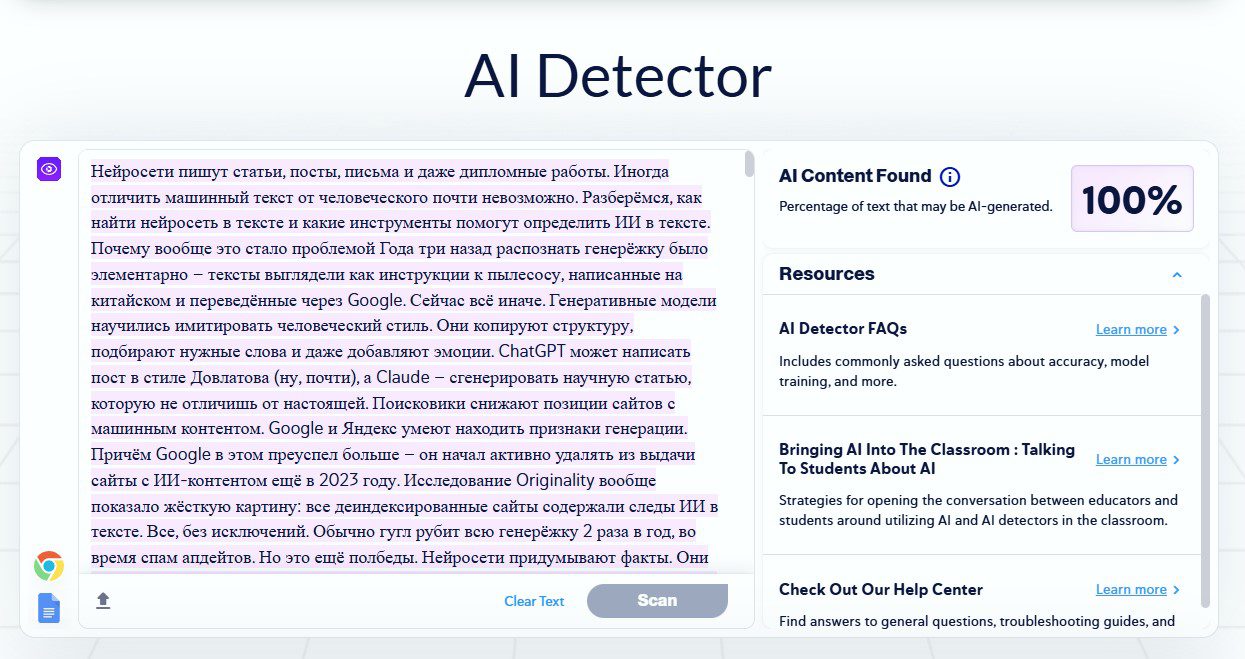
С русским хуже. Наша статья, по его мнению, это 100% генерёжка, как и действительно сгенерированный текст. Проблема с русским?
PR-CY
Ссылка https://pr-cy.ru/tools/ai-content-detector/
Российский сервис. Платный. После регистрации даёт 10 лимитов на проверку примерно 9000 символов. Дополнительная тысяча лимитов — 500 рублей.
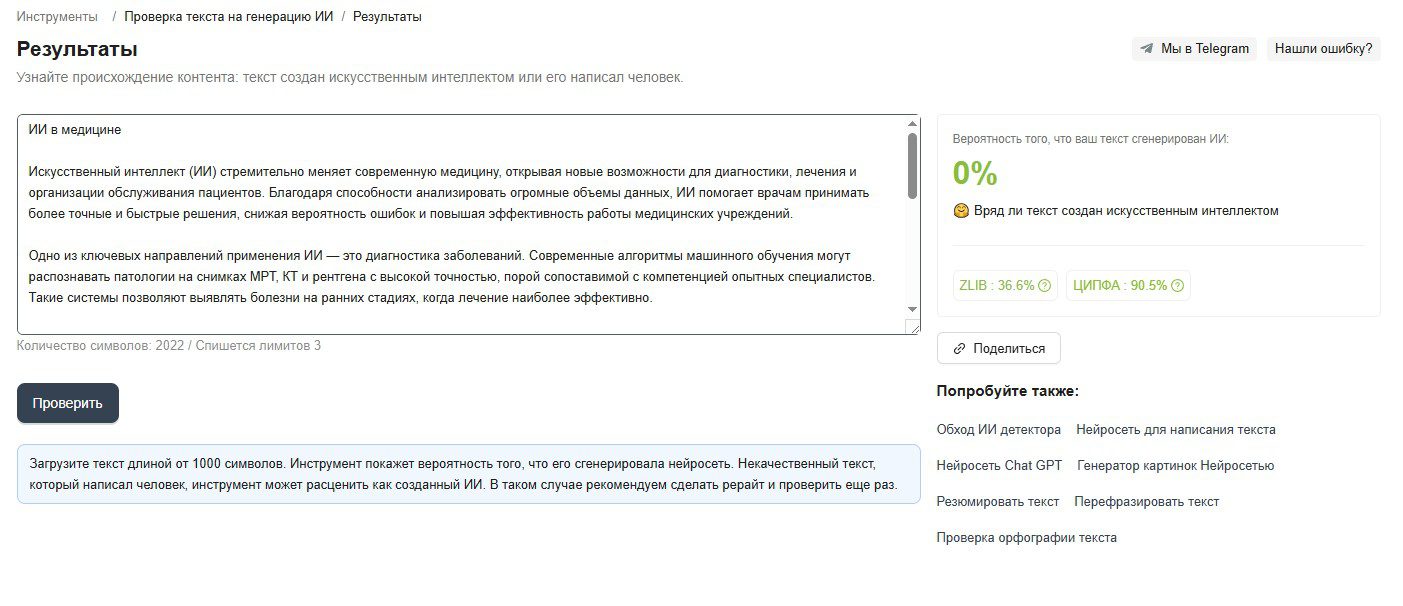
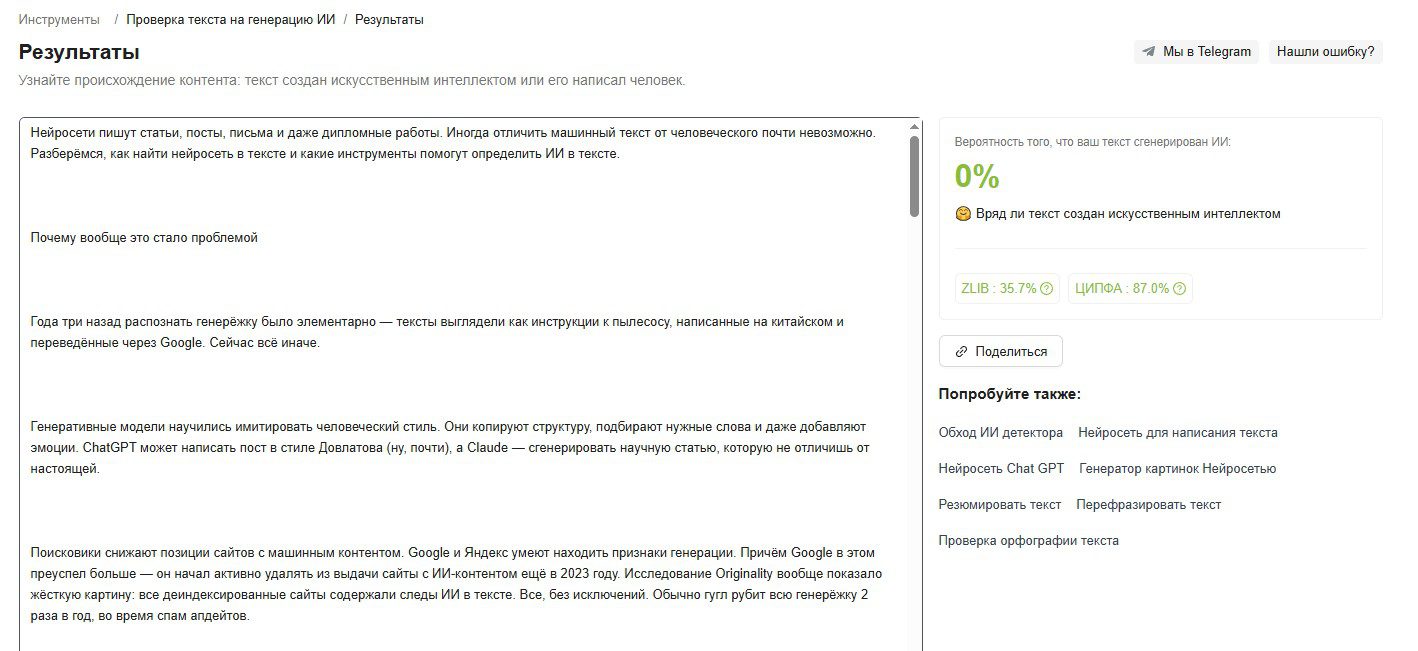
Из всех рассматриваемых в статье сервисов, он единственный кто генерёжку от GPT чата воспринял как человеческий текст. Наш текст тоже с 0% вероятностью написан ИИ (спасибо).
Как распознать ИИ в тексте без всяких сервисов
Детекторы — это хорошо, но они ошибаются. Постоянно. Я видел, как GigaCheck посчитал отрывок из Достоевского машинным (серьёзно, проверял из любопытства). Ручная проверка требует внимания к деталям, зато надёжнее. К тому же, если вы часто сами работаете с текстами и что-то генерируете, то все паттерны генерёжки вы будете уже на глаз определять. Выделим основные моменты:
- Странные формулировки — первый звоночек. Нейросети любят сравнения из другой реальности. “Как магический кристалл, показывающий путь”, “словно маяк в море информации”, “это компас в мире данных”. Живой человек так не напишет. Ну то есть может написать, если он копирайтер из нулевых, но это редкость. Видел недавно текст про маркетинг, где было написано: “Анализ рынка — это магический кристалл, который показывает, что происходит в сознании потребителя”. Магический кристалл, Карл! В деловом тексте про маркетинговый анализ.
- Неправильные слова-связки режут слух. “Ведь он позволяет заглянуть” вместо нормального “потому что позволяет”. Или “благодаря тому, что он открывает возможности” — чересчур громоздко. Машина пытается связать предложения, но выбирает неестественные конструкции. Человек использует простые связки: потому что, поэтому, однако, но. Нейросеть усложняет: “ввиду того что”, “в силу вышеизложенного”, “принимая во внимание”.
- Заглавные буквы после двоеточия. Это вообще классика жанра. Правила русского языка чёткие: после двоеточия строчная буква. Исключения — прямая речь или имя собственное. Нейросети плевать на правила. Она видела в обучающих данных заголовки списков с большой буквы и решила, что так правильно везде. “Преимущества очевидны: Экономия времени, Снижение затрат, Повышение эффективности”. Видите? Каждый пункт с заглавной. Это машина, можете не сомневаться.
- Отглагольные существительные выстраиваются в ряд. Когда весь список начинается одинаково — это подозрительно. “Формирование стратегии:”, “Определение целей:”, “Анализ результатов:”, “Оценка эффективности:”. Человек устанет так писать. Он бы хотя бы пару пунктов начал по-другому: “Как сформировать стратегию”, “Определяем цели”, “Анализируем результаты”.
Нейросеть любит шаблоны. Если нашла работающую структуру, применит ко всему списку. Без вариаций.
Как ещё можно обнаружить ИИ в тексте (и тут становится интереснее)
Помимо очевидных признаков есть тонкие детали. Их сложнее заметить, но они надёжнее.
Избыточная структура. Списки за списками. Таблицы после каждого раздела. Подзаголовки третьего уровня, которые дробят текст на микроскопические кусочки. Машина думает: больше структуры = лучше читабельность.
Человек понимает: слишком много структуры = раздражает. Мы не можем физически создать столько элементов. Нам лень. И это нормально.
Видел статью про инвестиции — там было 15 (!) подзаголовков H3 на 6000 символов. Каждый раздел разбит на три подраздела. Каждый подраздел — на пункты. Внутри пунктов — ещё списки. Это уже не статья, а оглавление справочника.
Вода течёт рекой. Одна простая мысль растягивается на три предложения.
“Являясь эффективным инструментом, позволяющим осуществлять комплексный подход к решению задач, данная методология обеспечивает достижение поставленных целей”.
А можно было: “Методология помогает решать задачи и достигать целей”. Но нет, нейросети нужно накрутить символов.
Причастные и деепричастные обороты громоздятся друг на друга. “Рассматривая вопрос, связанный с применением технологий, используемых в процессе создания контента…” — и так целый абзац. Задохнуться можно.
Одинаковая длина предложений создаёт убаюкивающий эффект. Читаешь и засыпаешь. Потому что ритма нет.
Люди пишут неровно. Короткое предложение. Потом длинное, с уточнениями, деталями и примерами, которые раскрывают мысль полнее. Снова короткое для акцента. Это создаёт ритм.
Нейросеть держит стабильность. Все предложения по 15-20 слов. Ровно. Как метроном. Читать такое некомфортно, хотя формально всё правильно.
Таблица для наглядности
| Признак | Как проявляется | Почему возникает |
|---|---|---|
| Штампы | “мощный инструмент”, “это как…”, “позволяет достичь” | Частые фразы в обучающих данных |
| Избыточные объяснения | Сначала тезис, потом “простыми словами”, потом список, потом таблица | Неверная интерпретация задачи “быть понятным” |
| Много жирного текста | Каждое второе слово выделено | Попытка сделать текст “структурированным” |
Скомканная середина — это вообще отдельная история.
Длинный текст начинается подробно. Вступление развёрнутое, примеры, аргументы. Концовка тоже ничего — выводы, обобщения. А середина? Конспект. Просто перечисление фактов без деталей.
Нейросеть экономит ресурсы. Ей нужно уложиться в лимит токенов, и она жертвует серединой. Начало важно, чтобы зацепить. Конец важен для выводов. А что посередине — неважно, пусть будет кратко.
Человек так не пишет. Мы не думаем категориями токенов. Мы либо раскрываем тему везде одинаково, либо акцентируем что-то конкретное. Но не обрубаем середину.
А что если попросить саму нейросеть найти нейросеть?
Парадокс, но работает. Иногда.
Берёте подозрительный текст. Идёте в ChatGPT, YaGPT или GigaChat. Даёте такой запрос:
“Проанализируй текст и определи, написан ли он нейросетью. Обрати внимание на: 1) обилие воды и причастий, 2) повторы слов и конструкций, 3) отглагольные существительные в начале строк, 4) ошибки согласования.”
Вставляете текст. Ждёте.
ChatGPT иногда выдаёт забавные результаты. Я тестировал на собственной статье (той, что писал руками). Он посчитал её машинной. Аргументы: “слишком логичная структура”, “переходы между абзацами выверены до механичности”.
То есть я хорошо написал = значит, написала машина. Обидно.
YaGPT осторожнее. Она даёт развёрнутый анализ и оставляет пространство для сомнений. “Может быть написано человеком, но структура наводит на мысли…” Дипломатично.
DeepSeek вообще красавец. Он пишет целое исследование на две страницы. Анализирует ритм, стиль, логику, приводит примеры. Правда, точность так себе — может ошибиться в любую сторону.
Лучше использовать несколько моделей сразу. Если все указали на признаки генерации — скорее всего, так и есть. Если мнения разделились — проверяйте вручную.
Что делать, если нашли следы ИИ в тексте
Обнаружили признаки машинного авторства. Дальше что?
Для студенческих работ всё строго. Многие вузы запрещают нейросети. НИУ ВШЭ с января 2024-го встроил детектор в антиплагиат. Уровень ИИ в тексте больше 40% — работу не принимают.
МГУ пошёл дальше — там вообще запретили ChatGPT на университетских компьютерах. Не знаю, как они технически это реализовали, но факт остаётся фактом.
Хотя, студенты всё равно используют. Просто научились лучше редактировать. То есть, генерируют черновик, потом переписывают каждое предложение своими словами. Добавляют личные примеры, меняют структуру. На выходе — текст, который детекторы не вычисляют. Кстати это вполне рабочий инструмент, который используют не только студенты, это действительно работает.
Для коммерческого контента критерии мягче. Главное — качество. Если текст полезен читателю, факты проверены, есть авторский опыт — можно использовать. Даже если изначально был сгенерирован. Но поисковики думают иначе. Google активно снижает позиции сайтов с машинным контентом. Даже если он качественный. Даже если полезный. Алгоритм видит признаки ИИ — позиции падают.
Заказчикам стоит прописать правила заранее. В техническом задании указать: допустимо ли использование нейросетей, какой процент содержания ИИ в тексте приемлем, обязательна ли редактура.
Пример как это можно написать в ТЗ: “Текст должен пройти проверку в трёх детекторах с результатом не выше 30% вероятности ИИ”. Жёстко, но понятно. Никаких споров потом.
Проверку лучше делать поэтапно. Сначала прогнать через 2-3 сервиса. Потом оценить вручную по признакам. Если сомнения остались — попросить автора показать черновики или объяснить ключевые тезисы.
Почему сервисы распознавания ИИ в тексте часто ошибаются (и это нормально)
Детекторы промахиваются чаще, чем хотелось бы. Это не баг, это фича. Ну ладно, баг… но объяснимый.
Формальный стиль всех путает. Юридические документы, техинструкции, научные статьи — детекторы считают их машинными. Потому что они написаны ровным языком, с терминами, строгой структурой.
Короткие тексты — это лотерея. Фрагмент в 500 символов может показать разные результаты в разных сервисах. GigaCheck скажет “человек”, GPTZero — “нейросеть”, PR-CY — “непонятно”.
Для точного анализа нужен объём. Минимум 2000-3000 символов. Лучше больше. На коротких отрезках статистика не работает.
Разные модели генерации детектятся по-разному. Инструменты обучались в основном на ChatGPT. Он популярный, данных много. Тексты от Claude, Gemini или YaGPT проскакивают незамеченными.
Переведённый контент — отдельная боль. Перевели с английского через DeepL или любой другой сервис для перевода текста, детектор видит неестественные конструкции и решает: “ИИ!”. Хотя исходник писал живой человек, просто перевод автоматический.
Что делать при спорных результатах?
Комбинировать методы. Проверить в трёх сервисах. Оценить вручную. При необходимости — запросить у автора исходники, черновики, объяснения.
Один детектор — это не основание для выводов. Это повод для дополнительной проверки.
Будущее этой гонки вооружений
Нейросети учатся писать естественнее. Детекторы учатся распознавать точнее. Это гонка без финиша.
GPT-5, Claude 4.5, Gemini 2.0 — все они генерируют тексты, которые трудно отличить от человеческих. Если дать модели подробный промпт с примерами стиля, референсами, ограничениями — на выходе будет текст, который обманет большинство детекторов.
Детекторы тоже не стоят на месте. Они добавляют новые параметры анализа: эмоциональную окраску, глубину аргументации, вариативность синтаксиса. Используют машинное обучение для адаптации к новым моделям. GigaCheck обновляется каждые два месяца. Content at Scale выпустил три крупных апдейта за полгода. Все понимают: стоит отстать — и твой детектор превратится в тыкву.
Интеграция в платформы становится нормой. WordPress-плагины проверяют статьи перед публикацией. Google Docs получил расширения для анализа ИИ в тексте. Скоро проверка станет автоматической. Написал текст в редакторе — система сама подсветила подозрительные места. Удобно.
Абсолютной точности не будет никогда. Это невозможно технически. Нейросети развиваются быстрее, чем методы их обнаружения. К тому же граница размывается. Человек использовал нейросеть для черновика (как в примере со студентами). Потом переписал половину текста. Добавил свои мысли, примеры, аргументы. Отредактировал структуру. Кто автор в итоге? 50 на 50? 60 на 40? Как это измерить?
Фокус смещается с детекции на качество. Не так важно, как создан материал. Важнее — приносит ли он пользу, корректны ли факты, интересен ли читателю. Проверка на уровень ИИ в тексте становится одним из критериев оценки. Но не главным. Главное — ценность для аудитории.
Практические советы по работе с детекторами нейросетей в тексте
Инструменты для определения текста, написанного нейросетью, требуют правильного использования. Несколько рекомендаций помогут получить точные результаты:
- Проверяйте текст частями. Большой материал разбейте на фрагменты по 3000-5000 символов. Так детекторы работают точнее. Некоторые сервисы явно указывают оптимальный объём.
- Используйте минимум три инструмента. Один может ошибиться, два дадут противоположные результаты, три — покажут тенденцию. Если все три указали на высокий уровень ИИ в тексте — вероятность велика.
- Обращайте внимание на выделенные фрагменты. Content at Scale и GPTZero показывают конкретные предложения, которые считают машинными. Проверьте их вручную — иногда это очевидные штампы, иногда — ложное срабатывание.
- Сравнивайте с другими текстами автора. Если человек раньше писал иначе, а теперь стиль резко изменился — это сигнал. Попросите объяснить сложные места или показать процесс работы.
- Не полагайтесь только на проценты. 65% вероятности генерации — что это значит? Разные сервисы считают по-разному. Смотрите на совокупность признаков, а не на одну цифру.
- Учитывайте контекст. Технический текст с терминами даст высокий процент, даже если написан человеком. Креативный рассказ с метафорами может показать низкий процент, хотя сгенерирован.
- Регулярно обновляйте список сервисов. Старые детекторы устаревают, новые появляются каждый месяц. То, что работало полгода назад, сейчас может давать ошибки. Следите за обновлениями и тестируйте новые инструменты.
Заключение
Распознать ИИ в тексте становится сложнее с каждым месяцем. Нейросети учатся имитировать человеческий стиль, детекторы догоняют их с переменным успехом. Абсолютной точности не существует и вряд ли появится в ближайшее время.
Комбинированный подход даёт лучшие результаты. Несколько сервисов для проверки на ИИ в тексте, ручной анализ по признакам, оценка контекста и стиля. Только так можно получить объективную картину.
Но главный вопрос не в том, как найти нейросеть в тексте. А в том, зачем это нужно. Если материал полезен, факты проверены, стиль адекватен — имеет ли значение происхождение? Инструмент остаётся инструментом. Важно, как его используют!